프로젝트 개요
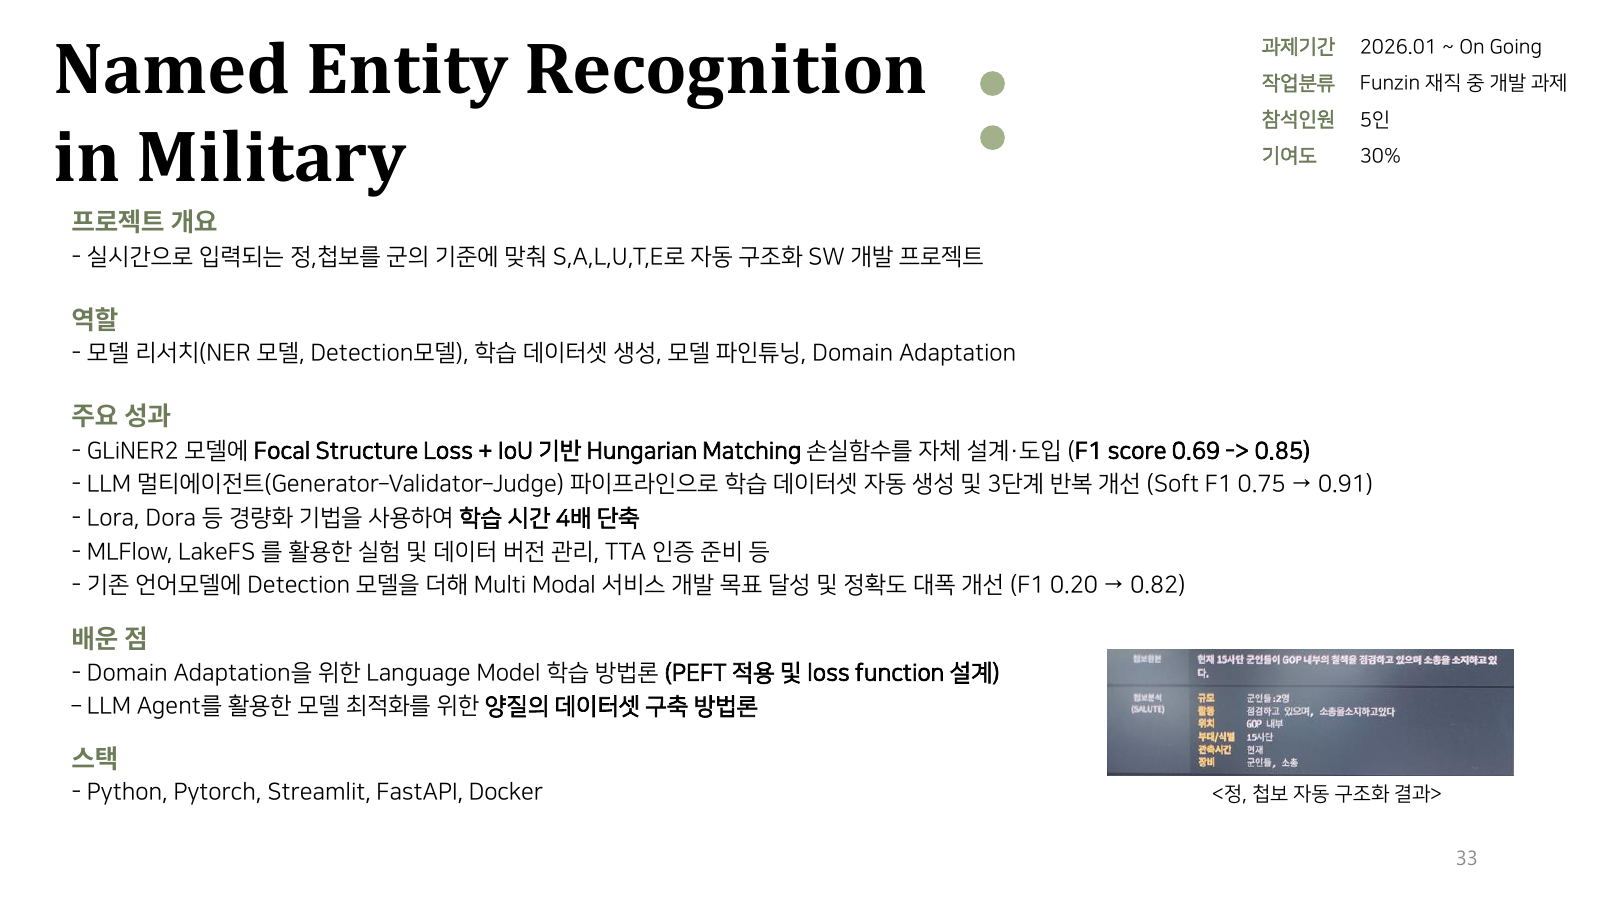
실시간으로 입력되는 정·첩보를 군 기준인 SALUTE(Size, Activity, Location, Unit, Time, Equipment) 구조로 자동 변환하는 소프트웨어를 개발했습니다. 텍스트 NER과 이미지 객체 탐지를 결합해 단일 언어 모델의 한계를 보완했습니다.
주요 역할
- NER·Object Detection 모델 리서치 및 Domain Adaptation
- LLM Multi-Agent 기반 학습·평가 데이터셋 생성
- GLiNER2 Fine-tuning 및 자체 Loss Function 설계
- YOLOv8 탐지 결과와 SALUTE JSON 결합
- MLflow·LakeFS 기반 실험 및 데이터 버전 관리
핵심 기여
1. LLM Multi-Agent Dataset Pipeline
- Generator–Validator–Judge 에이전트로 문장 생성, 답변 생성, 검증을 반복하는 파이프라인 설계
- 도메인 특화 4,000문장 학습·벤치마크 데이터셋 구축
- 번역–역번역 증강과 3단계 개선으로 Soft F1 0.75 → 0.91
2. GLiNER2 Loss Function 개선
- 문자 겹침 IoU와 Hungarian Matching으로 예측·정답 간 최적 정렬 구현
- Hard Example에 집중하는 Focal Structure Loss 설계
- Hard Sample F1 0.69 → 0.85 향상
3. Multimodal SALUTE Structuring
- YOLOv8 기반 전차·군인 Detector 결과를 NER의 SALUTE JSON에 결합
- 텍스트만으로 추정하기 어려운 Size F1 0.20 → 0.82 향상
- LoRA·DoRA로 Fine-tuning 시간을 4배 단축
주요 성과
- 원본 정보 대비 구조화 일치도: 텍스트 91.4%, 텍스트+이미지 90.4%
- 16건 동시 처리 0.25초, 과부하 환경에서도 건당 0.14초 이내 처리
- SCOPUS 등재 저널 투고 및 심사 진행 중
배운 점
- PEFT와 Loss Function 설계를 활용한 언어 모델 Domain Adaptation
- LLM Agent를 활용한 고품질 도메인 데이터셋 구축
- NER과 Object Detection을 결합한 Multimodal 서비스 설계